Teste de hipóteses: o que é, como fazer passo a passo e 4 exemplos resolvidos
A média caiu, mas caiu de verdade? O teste de hipóteses é a conta que separa a melhoria que veio do processo daquela que veio do acaso.

Na especialização em Estatística eu aprendi a fazer teste de hipóteses do jeito que se cobra em prova. Tinha a fórmula, tinha a tabela no anexo do livro e tinha o valor crítico para comparar. Eu acertava quase sempre. Saía da sala com a impressão confortável de que sabia usar aquilo.
O primeiro problema de verdade chegou anos depois, numa reunião de resultado. O indicador de erro tinha caído de 2,8% para 2,3% depois de uma mudança no processo. A sala queria comemorar. Um gerente de operações perguntou uma coisa simples: "isso é a mudança ou é o mês?" Eu tinha a fórmula inteira na cabeça e não soube responder. Ninguém tinha me ensinado que a pergunta vem antes da conta.
É exatamente essa pergunta que o teste de hipóteses responde. Ele não existe para calcular um valor de t. Ele existe para dizer se a diferença que você viu tem tamanho suficiente para não ser explicada pelo acaso. A prova da pós cobrava a segunda metade do trabalho. A operação cobra a primeira, e é a primeira que faz alguém mudar de decisão.
Este texto percorre o caminho inteiro, na ordem em que ele acontece dentro de um projeto. Primeiro, por que a média sozinha não prova nada. Depois, como escrever as duas hipóteses sem trocar o lado e o que o p-valor está de fato medindo. Na última parte, qual teste de hipóteses usar para cada tipo de dado e como isso vira decisão. Fecham o texto quatro exemplos resolvidos, cada um com um teste de hipóteses diferente, e um PDF de cada para você baixar e adaptar.
O que é um teste de hipóteses
Teste de hipóteses é o procedimento estatístico que decide, com um risco de erro declarado, se uma diferença observada nos dados é real ou se ela cabe dentro da variação normal do processo. Você escreve duas afirmações que se excluem, coleta uma amostra e compara o desvio observado com um limite definido antes da coleta.
A parte que costuma passar despercebida é a expressão "definido antes da coleta". O teste de hipóteses não é uma calculadora que você aponta para um número pronto. Ele é um compromisso que você assume antes de olhar o resultado: este é o tamanho de diferença que eu vou considerar convincente, e este é o risco de me enganar que eu aceito correr. Depois disso a conta apenas cumpre o combinado.
Sem esse compromisso, qualquer número vira prova de qualquer coisa. A pessoa olha a média que caiu e conclui que a ação funcionou. Olha a média que subiu num ponto e conclui que piorou. O que o teste de hipóteses faz é tirar essa decisão do gosto de quem está olhando e colocar numa régua que qualquer outra pessoa pode conferir com os mesmos dados.
Três coisas precisam existir para que um teste de hipóteses signifique alguma coisa:
- Duas hipóteses escritas antes: uma de que nada mudou e uma de que alguma coisa mudou. Elas cobrem todo o espaço de possibilidades e não se sobrepõem.
- Uma amostra com origem conhecida: os dados precisam vir de um plano de coleta de dados que diga quem mediu, com que instrumento, em que período e com qual critério de inclusão.
- Um risco declarado: o nível de significância, que é a chance que você aceita de gritar "mudou" quando nada mudou.
Falta qualquer um dos três e o resultado deixa de ser um teste de hipóteses. Vira uma conta bonita em cima de um palpite. Já vi projeto inteiro cair na revisão porque a amostra tinha sido escolhida depois, entre os dados que davam o resultado desejado.
O teste de hipóteses também não decide sozinho o que fazer. Ele responde a uma pergunta fechada e devolve uma probabilidade. Quem decide continua sendo gente, olhando o tamanho do efeito, o custo da ação e o risco de errar para cada lado. Essa fronteira é a que mais se perde quando o método é ensinado só como fórmula.
Dentro de um projeto estruturado, o teste de hipóteses mora na fase de análise do método DMAIC. É ele que separa as causas que a equipe suspeita das causas que a equipe consegue provar. Na fase de controle ele volta, agora para confirmar que o novo patamar do indicador é diferente do antigo e não apenas um trecho de sorte.
Por que a média que melhorou não prova nada
Todo processo varia. Meça o mesmo indicador em duas semanas iguais, sem mudar nada, e os dois números vão ser diferentes. Essa diferença não tem culpado. Ela é a variação comum do processo, aquela que nasce de dezenas de causas pequenas atuando ao mesmo tempo: um lote de matéria-prima ligeiramente diferente, uma temperatura que oscilou, um operador mais rápido que outro.
Quando você compara o antes e o depois de uma ação, está comparando duas médias que já seriam diferentes mesmo sem a ação. A pergunta correta nunca foi "a média mudou". Foi "a média mudou mais do que ela mudaria sozinha".
É por isso que estatística descritiva não fecha a conta. Ela descreve o que aconteceu com clareza, e descrever é indispensável. Mas média, moda e mediana não carregam nenhuma informação sobre o quanto aquele valor poderia ter saído diferente por acaso. Quem carrega isso é a dispersão, medida pelo desvio padrão, e o tamanho da amostra.
Dois números com a mesma diferença de média podem levar a conclusões opostas. Se o processo é estável e a dispersão é pequena, uma queda de meio ponto percentual pode ser enorme. Se o processo oscila muito, a mesma queda cabe folgadamente dentro do ruído de qualquer semana. O teste de hipóteses é justamente a conta que pesa a diferença contra a dispersão.

Como a decisão é tomada com uma amostra e não com a população inteira, sempre existe chance de errar. E existem dois erros diferentes, com consequências diferentes, que a figura acima separa.
| Erro | O que aconteceu | Nome comum | Custo típico no projeto |
|---|---|---|---|
| Tipo I (alfa) | Você rejeitou a hipótese nula, mas nada tinha mudado | Alarme falso | Implantar e pagar por uma ação que não resolve, e ainda declarar a causa como provada |
| Tipo II (beta) | Você não rejeitou a hipótese nula, mas alguma coisa tinha mudado | Cegueira | Descartar uma causa verdadeira e seguir procurando no lugar errado |
A escolha do nível de significância é a escolha de quanto erro tipo I você aceita. Adotar 5% quer dizer o seguinte: se eu repetisse esse teste de hipóteses cem vezes num processo onde nada mudou, eu gritaria "mudou" em cerca de cinco delas. É um custo que você assume conscientemente, não um detalhe de fórmula.
Os dois erros se empurram. Apertar o alfa para 1% reduz o alarme falso e aumenta a chance de deixar passar um efeito que existe. A saída não é escolher entre os dois. É aumentar o tamanho da amostra, que é a única variável capaz de reduzir os dois ao mesmo tempo.
Antes de qualquer teste de hipóteses, vale olhar o processo no tempo. Um gráfico sequencial ou uma carta de controle mostram se o que você tem é um processo estável com variação comum ou um processo com causa especial no meio da série. Testar a média de um processo instável é comparar duas coisas que não existem: nenhuma das duas médias representa o processo.
Essa é a ordem que eu defendo em qualquer projeto. Primeiro estabilidade, depois comparação. O controle estatístico de processo vem antes do teste de hipóteses, não depois dele.
H0 e H1: como escrever as duas hipóteses sem errar o lado
A hipótese nula, escrita H0, é sempre a afirmação de que nada mudou. O parâmetro é igual ao valor de referência, os dois grupos são iguais, as duas variáveis são independentes. Ela é a posição padrão, aquela que fica de pé até que a evidência a derrube.
A hipótese alternativa, escrita H1 ou HA, é a afirmação contrária. Ela carrega o que você suspeita, o que a ação pretendia causar, o que o projeto quer provar. E é sobre ela que o teste de hipóteses nunca se pronuncia diretamente.
Essa assimetria é a parte mais mal ensinada do assunto. Um teste de hipóteses só tem dois desfechos possíveis: rejeitar a hipótese nula, ou não rejeitar. Ele nunca aceita a nula, e nunca prova a alternativa. Não rejeitar quer dizer que a evidência daquela amostra não foi suficiente, o que é diferente de dizer que não há efeito.
Escrevo sempre a frase por extenso antes de escrever em símbolo, porque a frase revela o erro que o símbolo esconde. "O volume médio das garrafas é igual a 300 mL" é uma hipótese nula. "O turno da noite erra mais que os outros" é uma alternativa, e unilateral, o que muda o cálculo.
A escolha entre teste bilateral e unilateral é a que mais gera confusão, e ela precisa ser feita antes de ver o dado:
- Bilateral (H1: diferente de): você quer detectar qualquer diferença, para cima ou para baixo. É o padrão quando não há razão prévia para esperar um lado. O risco alfa se divide entre as duas caudas, 2,5% de cada lado quando alfa é 5%.
- Unilateral (H1: maior que, ou menor que): só interessa a diferença num sentido. Todo o risco alfa fica numa cauda só, o que torna o teste mais sensível naquele lado e completamente cego para o outro.
- A regra honesta: escolher unilateral depois de ver que o resultado foi para aquele lado é trapaça, e dobra na prática o seu alfa. Se a direção não estava decidida antes, o teste é bilateral.
Uma dica de campo que evita metade dos erros: o sinal de igual mora sempre na hipótese nula. H0 recebe igual, maior ou igual, menor ou igual. H1 recebe diferente, maior, menor. Se você escreveu igual nos dois lados, ou desigualdade nos dois, alguma coisa está trocada.
No capítulo 23 do Guia Prático Lean Seis Sigma Black Belt (Editora Atlas/GEN, 2025), o de Análise do Sistema de Medição, esse par aparece num uso que quase ninguém associa a teste de hipóteses. Na página 235 estão escritas as hipóteses da linearidade de um instrumento: “H0: inclinação = 0” contra “H1: inclinação ≠ 0”. Na página seguinte vem o par do intercepto, e a nula é definida como “intercepto = 0 (ausência de vício)”.
Guardo esse exemplo porque ele mostra o teste de hipóteses fora do lugar comum. Ali a hipótese nula é o resultado que a gente quer: inclinação zero significa instrumento linear, intercepto zero significa instrumento sem vício. O critério de aceitação impresso na página 235 é “se p ≥ 0,10, a linearidade é aceitável”. Repare que o alfa é 0,10 e não 0,05, porque o custo de deixar passar um instrumento viciado é alto e vale ser mais rigoroso.
Quando a nula é o resultado desejado, não rejeitar deixa de ser um resultado morno. Ele passa a ser o que se procura, e a lógica inteira do teste de hipóteses se inverte. Vale prestar atenção nisso ao montar um estudo de capabilidade do processo ou uma validação de instrumento.
O p-valor e o alfa: a régua que decide
O p-valor é a peça mais citada e mais mal explicada do método. Ele não é a probabilidade de a hipótese nula ser verdadeira. Ele também não é a probabilidade de você estar errado. Ele é uma coisa mais específica e mais estranha.
A definição que uso é a que escrevi no capítulo 24 do Guia Prático Lean Seis Sigma Black Belt, o de Estatística e Probabilidade. Na página 260 está assim: “o p-valor, que representa uma medida que indica a probabilidade de obter resultados tão grande ou maior do que os observados, assumindo que a hipótese nula é verdadeira. Se p ≥ 0,05, os dados são normais; se p < 0,05, os dados não são normais.”
A segunda frase está no contexto de um teste de normalidade, que é onde o trecho aparece no livro. A primeira frase é a que vale para qualquer teste de hipóteses, e ela merece ser lida devagar. O p-valor é calculado assumindo que a nula é verdadeira. Ele responde a uma pergunta condicional: se nada tivesse mudado, com que frequência eu veria um resultado tão extremo quanto este? É a mesma definição que o e-Handbook de estatística do NIST registra: a probabilidade de a estatística de teste ser pelo menos tão extrema quanto a observada, dado que a nula é verdadeira.
Um p de 0,03 quer dizer que num mundo onde nada mudou, resultados como o seu apareceriam em 3% das amostras. É pouco. Pouco o bastante para você preferir a explicação de que alguma coisa mudou. Não é uma prova, é uma preferência bem fundamentada entre duas explicações.
O alfa é o limite que você fixa antes. A comparação é direta: se o p-valor for menor que o alfa, rejeite a nula. Se for maior ou igual, não rejeite. Esse é o mecanismo inteiro da decisão, e ele cabe numa linha.
| Alfa adotado | Confiança | Quando faz sentido | Consequência prática |
|---|---|---|---|
| 0,10 | 90% | Triagem de causas, estudos exploratórios, MSA de linearidade | Detecta mais coisas e produz mais alarme falso |
| 0,05 | 95% | Padrão da maioria dos projetos de melhoria | O equilíbrio usual entre os dois erros |
| 0,01 | 99% | Segurança, saúde, decisão cara ou irreversível | Exige evidência forte e deixa passar efeitos pequenos |
Não existe alfa correto por natureza. Existe alfa coerente com o custo de errar. Numa triagem de causas, onde depois vem confirmação, deixar passar uma causa verdadeira custa mais caro que investigar uma falsa. Numa decisão de investir em equipamento, o custo se inverte.
Falta a advertência que sustenta tudo isso, e ela é a que mais me faz voltar em reunião: significância estatística não é relevância prática. Com amostra grande o suficiente, qualquer diferença minúscula fica significativa. Um p de 0,001 pode estar apontando uma diferença de média de 0,02% que não muda nada na operação.
Por isso o resultado de um teste de hipóteses sempre vem acompanhado de duas outras informações. O tamanho do efeito, que é a diferença em unidade de negócio. E o intervalo de confiança, que mostra a faixa de valores plausíveis para essa diferença. Um intervalo de confiança que vai de 0,1% a 4,3% conta uma história bem diferente de um que vai de 3,9% a 4,1%, mesmo com o mesmo p-valor.
Quem decide olhando só o p-valor acaba implantando ações caríssimas por efeitos irrelevantes, e descartando efeitos relevantes que a amostra pequena não conseguiu provar. Nos dois casos o teste de hipóteses estava certo. A leitura é que estava incompleta.
Qual teste de hipóteses usar: o mapa por tipo de dado
A pergunta "qual teste eu uso" tem resposta objetiva, e ela não depende do seu tema. Depende de três coisas: a natureza da variável de saída, quantos grupos você está comparando e se os dados atendem às premissas do teste de hipóteses.
A primeira divisão é entre dado contínuo e dado discreto. Contínuo é o que se mede numa escala: milímetro, minuto, real, grau. Discreto é o que se conta ou se classifica: aprovado ou reprovado, quantidade de defeitos, categoria de motivo. Essa fronteira define metade da escolha.

A figura acima é o caminho que eu percorro em toda análise. A tabela abaixo é a mesma decisão em formato de consulta, com a pergunta de negócio ao lado de cada teste.
| Pergunta que você está fazendo | Tipo de dado | Teste indicado | Premissa principal |
|---|---|---|---|
| A média do processo é igual a um valor de referência? | Contínuo, um grupo | Teste t de uma amostra | Dados aproximadamente normais |
| As médias de dois grupos são iguais? | Contínuo, dois grupos | Teste t de duas amostras | Normalidade e variâncias comparáveis |
| O antes e o depois do mesmo item mudou? | Contínuo, pares | Teste t pareado | Normalidade das diferenças |
| As médias de três ou mais grupos são iguais? | Contínuo, k grupos | ANOVA de um fator | Normalidade e variâncias homogêneas |
| A variabilidade de dois grupos é igual? | Contínuo | Teste F ou teste de Levene | Levene tolera desvio de normalidade |
| A proporção de defeituosos é igual a um alvo? | Discreto, um grupo | Teste de proporção de uma amostra | Amostra grande o bastante |
| Dois grupos têm a mesma proporção de defeituosos? | Discreto, dois grupos | Teste de duas proporções | Contagens mínimas em cada célula |
| Os defeitos se repartem igualmente entre as categorias? | Discreto, uma variável | Qui-quadrado de aderência | Frequência esperada de pelo menos 5 por célula |
| A categoria do defeito depende do turno, da linha ou do fornecedor? | Discreto, tabela cruzada | Qui-quadrado de independência | Frequência esperada de pelo menos 5 por célula |
| As médias diferem, mas os dados não são normais? | Contínuo não normal | Mann-Whitney ou Kruskal-Wallis | Compara medianas, não médias |
Vale explicar de onde vem cada distribuição, porque isso desmistifica a tabela. No capítulo 24 do livro eu descrevo a distribuição t na seção 24.3.3. A frase que resume o papel dela é esta: “sua principal aplicação é na inferência estatística, em que é usada para testar hipóteses sobre a média populacional a partir de uma amostra”. A distribuição qui-quadrado vem logo antes, na 24.3.2, e é a que serve para contagem e categoria.
Sobre a distribuição t vale registrar a linha técnica impressa na página 264, a mesma do exemplo que eu resolvo mais adiante: “Se uma amostra aleatória X1, X2, ... Xn de tamanho n e normalmente distribuída, com média desconhecida e variância finita, então T é distribuído (distribuição t)”, com n menos 1 graus de liberdade. É esse "menos 1" que aparece em toda tabela de valor crítico.
Duas armadilhas de escolha aparecem sempre. A primeira é usar teste t sucessivo para comparar três ou mais grupos, dois a dois. Com três grupos são três comparações, e o risco de alarme falso deixa de ser 5% e vira algo perto de 14%. Para três ou mais grupos o caminho é ANOVA, que testa tudo de uma vez e mantém o alfa no lugar.
A segunda é ignorar a premissa de normalidade. Antes de qualquer teste de média eu rodo um teste de normalidade nos dados, e é ali que a frase da página 260 se aplica ao pé da letra: p maior ou igual a 0,05 indica dados normais. Se a normalidade cai, o caminho não é forçar o teste t. É usar o equivalente não paramétrico ou transformar os dados.
Um histograma e um boxplot resolvem boa parte dessa inspeção antes de qualquer conta. Eles mostram assimetria, valores extremos e distribuições com duas modas, que é o sinal clássico de que existem dois processos misturados na mesma coluna de dados. Nesse caso o problema não é escolher o teste de hipóteses, é estratificar os dados.
Quando a pergunta é sobre relação entre duas variáveis contínuas, e não sobre diferença de média, a família muda. Aí entram o diagrama de dispersão e a regressão linear, que também terminam num teste de hipóteses sobre os coeficientes, como no exemplo de linearidade do capítulo 23.
Como fazer um teste de hipóteses passo a passo
A sequência abaixo é a que eu uso e a que eu cobro em revisão de projeto. A ordem importa porque cada passo fecha uma porta de trapaça do passo seguinte.

- Escreva a pergunta de negócio. Em uma frase, sem termo estatístico. "A folga média saiu do centro da especificação?" é uma pergunta. "Rodar teste t nos dados de folga" não é.
- Traduza em H0 e H1. Por extenso primeiro, em símbolo depois. Decida agora se o teste é bilateral ou unilateral.
- Fixe o alfa e o tamanho da amostra. Antes de coletar. O tamanho vem do efeito mínimo que interessa detectar e da dispersão estimada do processo.
- Colete os dados segundo um plano. Com origem, período, instrumento e critério de inclusão registrados. Amostra escolhida depois de ver o resultado invalida o teste inteiro.
- Verifique as premissas. Normalidade quando o teste pede, estabilidade do processo, independência das observações e contagem mínima por célula em testes de categoria.
- Escolha o teste de hipóteses e calcule. Pelo mapa da seção anterior. A conta pode sair no Minitab, no Excel ou na mão, o resultado é o mesmo.
- Decida e registre. Compare p com alfa, mas escreva a conclusão em linguagem de negócio, com o tamanho do efeito e o intervalo de confiança ao lado.
Para ver a mecânica inteira num caso pequeno, uso o exemplo que está impresso na página 264 do livro, no capítulo 24. Ele é curto e tem todos os elementos.
Foram coletados dados da medição do volume de garrafas de refrigerante, para analisar se ele é estatisticamente diferente de 300 mL. Foram realizadas 100 medições. A média encontrada foi de 299,169 mL e o desvio padrão de 3,246. As hipóteses testadas foram “H0: volume igual a 300 mL” e “HA: volume diferente de 300 mL”, o que faz do teste um bilateral de uma amostra.
A estatística de teste sai da diferença entre a média medida e o valor de referência, dividida pelo erro padrão. Com 299,169 contra 300, desvio padrão de 3,246 e amostra de 100, o valor calculado é t = 2,56. Repare que a diferença bruta é de apenas 0,831 mL, menos de um mililitro numa garrafa de 300.
Falta o valor crítico. Para 95% de confiança num teste bilateral, o alfa de 0,05 se divide e a tabela é consultada em 0,025. Com 99 graus de liberdade, que é o n menos 1 da amostra de 100, a tabela do anexo devolve 1,984. A regra fica escrita assim: se t for maior que 1,984, a hipótese nula será rejeitada.
Como 2,56 é maior que 1,984, a hipótese nula é rejeitada. A conclusão impressa no livro é direta: o volume médio das garrafas não é igual a 300 mL. Menos de um mililitro de diferença virou uma conclusão firme, e virou porque a dispersão era pequena e a amostra tinha cem medições.
Esse é o ponto que eu peço para guardar deste exemplo. O que tornou a diferença significativa não foi o tamanho dela. Foi a relação entre a diferença, a dispersão e o tamanho da amostra. Com dez medições em vez de cem, o mesmo 0,831 mL não seria rejeitável.
E aqui volta a advertência da seção anterior. O teste de hipóteses provou que o volume não é 300 mL. Se 299,169 mL é um problema para o cliente, para a legislação metrológica ou para o custo de enchimento, é outra pergunta, e ela não é estatística. É de negócio.
Quatro exemplos resolvidos, um para cada teste
Os quatro exemplos abaixo saem de setores diferentes e usam testes diferentes de propósito. Um qui-quadrado, um teste t de uma amostra, um teste de duas proporções e um teste t de duas amostras. Juntos eles cobrem os quatro caminhos mais frequentes do mapa.
Uma observação de honestidade antes de cada um. Os números de partida vêm de documentos de projeto reais. O teste de hipóteses formal montado sobre eles é reconstrução didática: nenhum desses projetos declarou ter rodado modelagem estatística, e onde uma informação necessária para fechar a conta não estava impressa, ela está marcada como valor adotado.
Cada exemplo tem uma folha em PDF com a pergunta de negócio, o par de hipóteses, o alfa, os dados, a estatística calculada, o valor crítico, a decisão e a linha de procedência. Use como modelo e troque os dados pelos seus.
1. Logística: qui-quadrado de aderência para saber se o erro se distribui igual entre os turnos
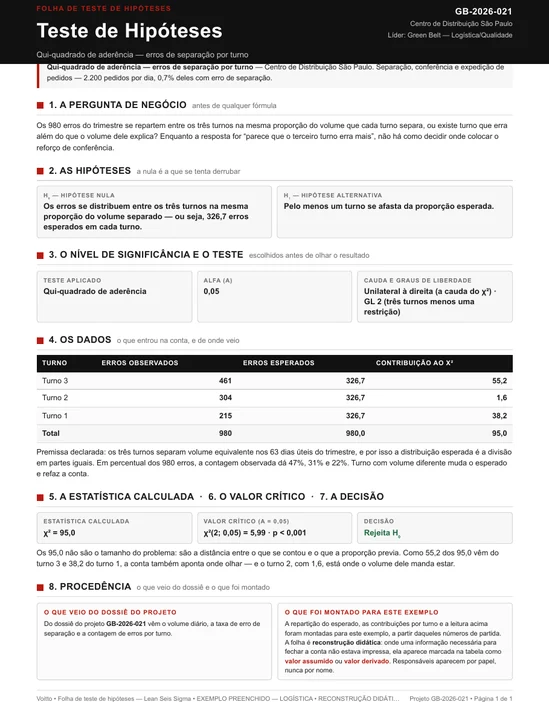 O contexto é um centro de distribuição que expede cerca de 2.200 pedidos por dia e tinha 0,7% deles saindo com pelo menos um erro de separação. A segunda camada de Pareto sobre os 980 erros dos 63 dias úteis do trimestre repartiu assim por turno: 461 no turno 3, o noturno, 304 no turno 2 e 215 no turno 1. Em percentual, 47%, 31% e 22%.
A pergunta de negócio é simples e cara: o turno da noite erra mais, ou ele apenas movimenta mais volume? A resposta muda a ação. Se for volume, o caminho é dimensionamento. Se for turno, o caminho é o que o Ishikawa apontou ali: rotatividade alta, separação por descrição sem leitura de código e conferência feita de memória.
Contagem em três categorias contra uma proporção esperada: isso pede qui-quadrado de aderência, e é o teste de hipóteses que eu rodo aqui. A hipótese nula diz que os erros se distribuem entre os turnos na mesma proporção do volume expedido. A alternativa diz que não. Adotei alfa de 0,05 e a premissa de que os três turnos expedem volume equivalente, premissa que está declarada na folha porque o documento não traz a expedição por turno.
Sob a nula, o esperado é 326,7 erros por turno. As contribuições ficam em 55,2 para o turno 3, 1,6 para o turno 2 e 38,2 para o turno 1, e o qui-quadrado total dá 95,0 com 2 graus de liberdade.
O valor crítico a 5% é 5,99. Como 95,0 é muito maior, a hipótese nula cai e o p-valor fica abaixo de 0,001.
A conclusão em linguagem de negócio: o erro não está distribuído por acaso entre os turnos, e o turno 3 concentra desvio muito acima do esperado. Uma nota de procedência: o documento do projeto registra os erros por turno e a estratificação que apontou as causas. O qui-quadrado apresentado aqui é reconstrução didática montada sobre esses números.
2. Indústria: teste t de uma amostra contra a especificação de folga
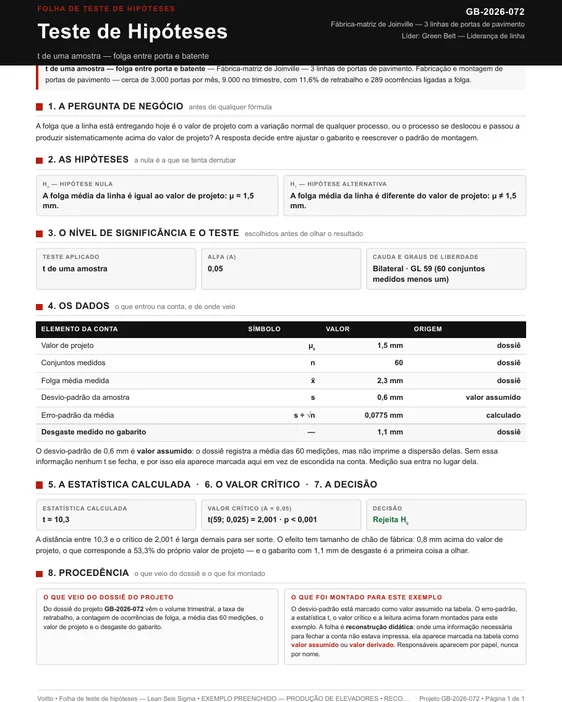 Uma fábrica de portas de pavimento com três linhas e produção mensal na casa de 3.000 portas tinha 11,6% de retrabalho antes da expedição. O segundo defeito do Pareto era folga fora de tolerância entre porta e batente, com 289 ocorrências nas cerca de 9.000 portas do trimestre. A folga de projeto entre porta e batente é de 1,5 mm.
A equipe mediu 60 conjuntos porta e batente e encontrou folga média de 2,3 mm, com desgaste de 1,1 mm nos encostos do gabarito de uma das linhas. A pergunta de negócio: essa média de 2,3 mm é um desvio real do valor de projeto, ou é a variação normal de medição de sessenta peças?
Variável contínua com um valor de referência do outro lado: t de uma amostra. Nula: folga média igual aos 1,5 mm de projeto. Alternativa: diferente disso, o que faz um teste bilateral. Alfa de 0,05 e 59 graus de liberdade, um a menos que o tamanho da amostra.
O documento traz a média e o tamanho da amostra, mas não traz o desvio padrão. Para fechar a conta adotei 0,6 mm, e esse valor está marcado na folha como assumido. Com ele, o erro padrão fica em 0,0775 mm e a estatística sai em t igual a 10,3. O valor crítico bilateral para 59 graus de liberdade é 2,001.
O teste devolve 10,3 onde a tabela do t cobrava 2,001, e essa distância é larga demais para ser sorte: a nula não sobrevive a ela. A folga média é estatisticamente diferente do valor de projeto, e o tamanho do efeito é de 0,8 mm, mais da metade do próprio valor de projeto. Aqui a relevância prática acompanha a significância, o que nem sempre acontece. A ação que saiu disso foi calibre passa não passa e recuperação do gabarito.
3. Financeiro: teste de duas proporções para provar que a glosa caiu
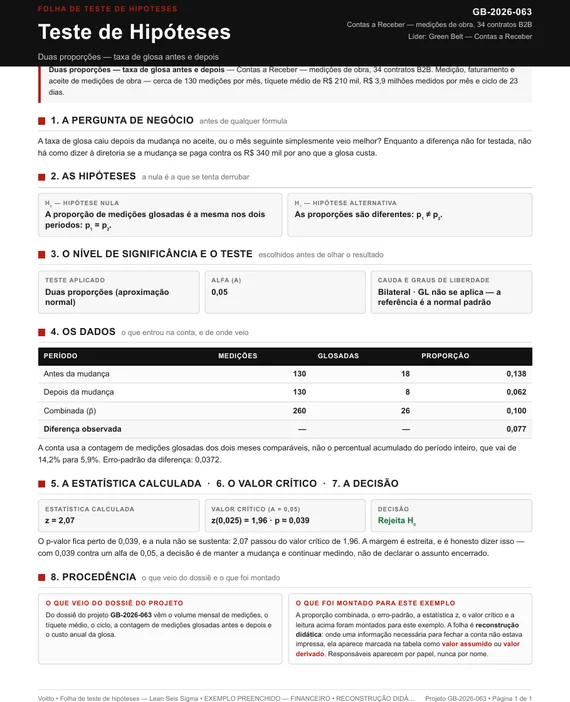 Uma construtora emite 130 medições de obra por mês, em média, para clientes corporativos, com tíquete médio de R$ 210 mil. Antes do projeto, 14,2% dessas medições voltavam com apontamento do cliente, o que empurrava perto de R$ 3,9 milhões por mês para um ciclo de reapresentação de 23 dias. Depois das ações, a taxa ficou em 5,9%. Antes de comemorar, alguém tem de perguntar se essa queda é efeito das ações ou oscilação de mês. A resposta importa porque o projeto foi certificado com base nela, e porque a Controladoria valorizou a perda em R$ 340 mil por ano.
Quando a Controladoria me mostrou os dois períodos lado a lado, eu fui para o teste de hipóteses de duas proporções: variável do tipo passa ou não passa, dois grupos. Sob a nula, a proporção de medições glosadas é a mesma nos dois períodos, e a alternativa abre para os dois lados, com alfa de 0,05.
Cada período entra com um mês de faturamento, ou seja, 130 medições de cada lado. Convertendo os percentuais para contagem, ficam 18 medições glosadas antes e 8 depois. A proporção combinada dos dois períodos é 0,100. O erro padrão da diferença sai em 0,0372 e a diferença observada entre as duas taxas é de 0,077, o que dá um escore z de 2,07. O valor crítico bilateral a 5% é 1,96.
O p-valor fica perto de 0,039, e a nula não se sustenta: 2,07 passou da fronteira de 1,96. A queda da glosa não se explica por acaso a 5% de significância. Nota de procedência: percentuais, volume mensal e valorização da perda saem do relatório do case. A conversão em contagem e o teste são reconstrução didática, e o dossiê do projeto não registra teste estatístico nenhum.
4. Sustentabilidade: teste t de duas amostras no consumo antes e depois
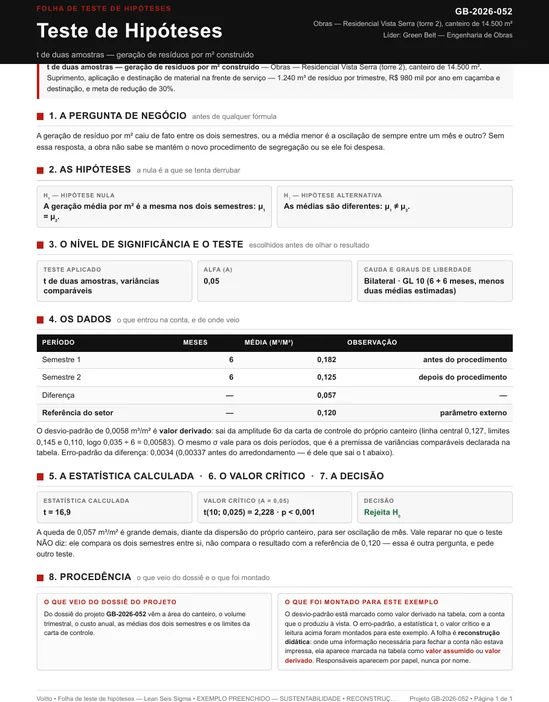 Um canteiro de 14.500 m² gerava 0,182 m³ de resíduo por metro quadrado construído, contra uma boa prática de referência de 0,12. Isso dava 1.240 m³ descartados por trimestre e uma perda valorizada em torno de R$ 980 mil por ano, entre caçamba, transporte, destinação e material comprado que virava entulho.
Depois do projeto, o indicador ficou em 0,125 m³/m². O que a diretoria queria saber era uma coisa só: o novo patamar é diferente do antigo, ou está dentro da oscilação que o canteiro já tinha? A resposta sustenta o compromisso de reduzir 30% o resíduo por metro quadrado.
Aqui eu comparo duas médias independentes, o antes e o depois do canteiro, e o teste de hipóteses que faz isso é o t de duas amostras. A nula diz que as duas médias são iguais e a alternativa diz que são diferentes, com alfa de 0,05 e seis meses de observação em cada período, o que dá 10 graus de liberdade.
O desvio padrão não está impresso no documento, mas dá para derivar. A carta do novo patamar traz linha central de 0,127 e limites de 0,145 e 0,110. Numa carta de valores individuais essa distância entre os limites equivale a seis desvios padrão, o que coloca o desvio em cerca de 0,0058 m³/m². A folha registra que esse valor é derivado, não medido. Uso o mesmo desvio nos dois períodos, o que assume variâncias comparáveis, premissa que a tabela do mapa lista para esse teste.
Com diferença de 0,057 entre as médias e erro padrão de 0,00337, a estatística fica em t igual a 16,9, contra um valor crítico de 2,228. A nula cai com folga enorme. Em linguagem de negócio: a queda de 0,182 para 0,125 m³/m² é um novo patamar do processo, não uma sequência de meses bons. Os números de partida estão impressos na documentação do case, e o teste é reconstrução didática.
Repare no que os quatro têm em comum. Em nenhum deles o teste de hipóteses descobriu a causa. A causa foi levantada antes, por Ishikawa, por 5 porquês e por matriz de causa e efeito. O teste de hipóteses entrou depois, para dizer quais daquelas suspeitas se sustentavam nos dados.
Essa ordem é a que separa projeto que anda de projeto que gira. Ferramenta de análise gera hipótese, teste de hipóteses confirma ou derruba. Inverter isso é sair pescando significância em qualquer cruzamento de coluna, e com dado suficiente sempre aparece algum cruzamento significativo que não quer dizer nada.
Os erros que fazem o teste de hipóteses mentir
Todo erro grave que já vi em teste de hipóteses cabe em uma destas seis linhas. Nenhuma delas é de conta. Todas são de método, e por isso passam despercebidas por quem confere só o resultado do software.
- Definir a hipótese depois de ver o dado. É o erro que mais reprova projeto em banca. Se a direção do teste de hipóteses ou o recorte da amostra foi decidido olhando o resultado, o alfa declarado não vale mais nada.
- Testar um processo instável. Se a série tem causa especial no meio, nenhuma das duas médias representa o processo. Primeiro estabilizar, depois comparar.
- Comparar vários grupos dois a dois com teste t. Cada comparação carrega o próprio alfa, e eles se acumulam. Três grupos já levam o risco real de alarme falso de 5% para perto de 14%.
- Ignorar a premissa de normalidade. Teste t em dados fortemente assimétricos devolve p-valor que não significa o que promete. O caminho é o equivalente não paramétrico.
- Confundir significância com relevância. Com amostra grande, diferenças irrelevantes ficam significativas. Sempre reportar o tamanho do efeito em unidade de negócio.
- Concluir que não há efeito porque não rejeitou. Não rejeitar a nula é falta de evidência, não evidência de ausência. Muitas vezes o que faltou foi tamanho de amostra.
Tem um sétimo erro que não é de estatística e derruba mais projeto que todos os outros juntos: dado de origem duvidosa. Nenhum teste de hipóteses conserta uma medição feita com instrumento descalibrado, um apontamento agregado que perdeu a estratificação ou uma coluna preenchida por três pessoas com critérios diferentes.
É por isso que a análise do sistema de medição vem antes. Se o instrumento tem vício ou falta de linearidade, o teste de hipóteses vai medir o instrumento e não o processo. Foi o que o exemplo da página 235 do livro mostrou: a linearidade também se decide por hipótese, e ela se decide primeiro.
Sobre a leitura do resultado, mantenho uma regra que já me salvou de muita reunião ruim. Escrever a conclusão em duas frases, sendo a primeira em linguagem de negócio e a segunda em linguagem estatística. "O turno da noite erra proporcionalmente mais que os outros dois." E então: "qui-quadrado de 95,0 com 2 graus de liberdade, p abaixo de 0,001, a 5% de significância."
Quem lê a primeira frase decide. Quem lê a segunda confere. Nenhuma das duas sozinha faz o serviço, e a ordem entre elas não é detalhe de estilo. Relatório que abre com o valor de p perde o interlocutor antes da conclusão.
Se você quiser levar isso para dentro de um projeto, o teste de hipóteses é uma das ferramentas do Lean Seis Sigma e se conecta com quase todas as outras. Ele fecha a fase de análise, alimenta o plano de controle com o novo patamar do indicador e sustenta o cálculo de nível sigma antes e depois. Reuni os modelos que a gente usa nos projetos no kit de ferramentas Lean Seis Sigma, com as 7 ferramentas da qualidade e as ferramentas estatísticas que aparecem neste texto. Quem quiser exercitar essa decisão num projeto de verdade, do problema ao indicador controlado, encontra o caminho nas academias de certificação da Voitto.
E vale a resposta que eu não soube dar naquela reunião, anos depois. Quando alguém perguntar se a melhoria foi real ou foi o mês, a resposta certa não é um número. É outra pergunta: quanto de diferença você considera convincente, e quanto risco de errar você aceita correr? Combinado isso, a conta é a parte fácil.